Novogene Korea
  • Novogene Korea
  • Genomics
    • Human Whole Genome Sequencing
    • Plant & Animal Whole Genome Sequencing
    • Microbial Whole Genome Sequencing
    • Whole Exome Sequencing
    • Plant & Animal De novo Sequencing
    • Microbial De novo Sequencing
    • Amplicon Sequencing
    • Shotgun Metagenomics Sequencing
    Transcriptomics
    • mRNA Sequencing
    • Total RNA Sequencing
    • Full-Length Transcriptome Sequencing
    • Whole Transcriptome Sequencing
    • Small RNA Sequencing
    • Circular RNA Sequencing
    • Metatranscriptome Sequencing
    • Prokaryotic RNA Sequencing
    Single Cell & Spatial Omics
    • Single Cell Gene Expression
    • Single Cell Immune Profiling Sequencing
    • Single Cell Long Read Transcriptome
    • Visium HD Spatial Gene Expression
    • Stereo-Seq Spatial Gene Expression
    • Xenium In Situ Spatial Transcriptome
    Epigenomics
    • Whole Genome Bisulfite Sequencing (WGBS)
    • Directed DNA Methylation Sequencing (DM-Seq) NEW
    • Reduced Representation Bisulfite Sequencing (RRBS)
    • Chromatin Immunoprecipitation Sequencing (ChIP-seq)
    • RNA Immunoprecipitation Sequencing (RIP-seq)
    • Assay for Transposase-Accessible Chromatin with Sequencing (ATAC-seq)

    Premade Library

    • Sequencing Only (Illumina 플랫폼)
    • Sequencing Only (PacBio 플랫폼)
    Proteomics & Metabolomics
    • Olink Proteomics
    • Quantitative Proteomics (MS)
    • Untargeted Metabolomics (MS)
  • 프로모션프로모션
    • 플랫폼
    • 자동화 운송 플랫폼 (Falcon)
    • BI 분석툴 (NovoMagic)
    • Customer Service System (CSS)
    • 브로셔
    • 케이스 스터디
    • 웨비나
    • 블로그
    • 샘플준비 가이드라인
    • 커뮤니티
    • 암 연구
    • 면역 종양학
    • 농업
    • 환경
    • 식품
    • 인간 마이크로바이옴
    • 동물 & 식물 마이크로바이옴
    • 신약개발
    • 희귀 질환 연구
    • 회사소개
    • 글로벌 입지
    • 뉴스룸
    • 채용 정보
  • 문의하기문의하기

서비스서비스 menu

고객지원고객지원 menu

기업정보기업정보 menu

서비스
WGSDe novo SeqAmplicon SeqShotgun MetagenomeDM-SeqmRNA-SeqSingle Cell Gene ExpressionVisium HDXenium In SituOlinkUntargeted Metabolomics
고객지원
노보매직CSSFalcon 플랫폼
기업정보
회사소개글로벌 입지플랫폼뉴스룸채용 정보문의하기
LinkedInLinkedIn hoverYouTubeYouTube hoverXX hoverMetaMeta hoverInstagramInstagram hover
Copyright © 2026 Novogene Co., Ltd. All Rights Reserved. 노보진의 한국 내 모든 서비스는 연구 목적 (Research Use Only, RUO) 으로만 제공됩니다. 사업자등록번호: 494-86-03792 | 판매자번호: 노보진코리아유한회사 | 대표자명: 리휘시앙 | 사업자주소: 서울시 강서구 마곡동 779-1번지 뉴브클라우드힐스 BT-230, 231호, 07790 | 전화번호: 02-2038-8036
banner laptop bg
banner mobile bg

mRNA Seq

RNA-Seq을 대표하는 서비스 Messenger RNA 발현에서 Transcript level의 분석과 유전자 조절 변화 및 생물학적 상태 전반에 대한 시퀀싱 분석 서비스이다.
견적 요청하기
(mRNA Seq)
견적 요청하기
(mRNA Seq)
개요개요
서비스 특징서비스 특징
적용 분야적용 분야
세부사항세부사항
데이터 분석데이터 분석

mRNA 시퀀싱(RNA-Seq)은 세포 기능 연구에 혁신을 가져오며, 연구자들에게 세포의 전사체 환경에 대한 전례 없는 인사이트를 제공합니다. 이 기술은 alternative splicing, novel gene, RNA SV 부터 유전자 발현 패턴 프로파일링에 이르기까지 연구를 진전시키는 데 필수적인 정확한 데이터를 제공하며, 질병 메커니즘 연구, 바이오마커 발견, 유전자 기능 분석 분야에서 활용됩니다.


Novogene은 완전 통합된 엔드투엔드 RNA-Seq 솔루션을 제공합니다. 저희의 워크플로우는 RNA 추출과 라이브러리 준비부터 시퀀싱, 그리고 포괄적인 BI 분석에 이르기까지 전 과정을 아우릅니다. 업계 최대 규모의 시퀀싱 역량과 엄격한 단계별 QC과정을 바탕으로, 최첨단 Illumina NovaSeq 플랫폼을 활용해 신뢰할 수 있는 고품질의 데이터를 빠른 속도로 제공합니다. 저희 NovoMagic 클라우드 플랫폼은 이 데이터를 설명 가능한 생물학적 인사이트로 변환할 수 있게 해주며, 하나의 플랫폼에서 결과를 쉽게 시각화하고 맞춤형으로 재분석할 수 있도록 서포트합니다.

노보진의 mRNA-seq 서비스: 장점 & 특징

광범위한 실험 경험
광범위한 실험 경험

매년 100만 개 이상의 RNA-seq 샘플을 정교한 워크플로우로 처리합니다.

광범위한 실험 경험
광범위한 실험 경험

매년 100만 개 이상의 RNA-seq 샘플을 정교한 워크플로우로 처리합니다.

클라우드형 BI툴 - NovoMagic

언제 어디서나 빠르고 자율성이 있는 분석과 비주얼리제이션을 수행하세요.

클라우드형 BI툴 - NovoMagic

언제 어디서나 빠르고 자율성이 있는 분석과 비주얼리제이션을 수행하세요.

로컬 서포트
로컬 서포트

지역별 기술지원팀과 연구소가 맞춤형이고 신속한 서비스를 제공합니다.

로컬 서포트
로컬 서포트

지역별 기술지원팀과 연구소가 맞춤형이고 신속한 서비스를 제공합니다.

종합 맞춤형 솔루션
종합 맞춤형 솔루션

복잡한 시료와 까다로운 연구 디자인에 맞추어 유연한 프로젝트를 설계합니다.

종합 맞춤형 솔루션
종합 맞춤형 솔루션

복잡한 시료와 까다로운 연구 디자인에 맞추어 유연한 프로젝트를 설계합니다.

빠르고 확실한 TAT
빠르고 확실한 TAT

QC 통과 후 약 2주 후 데이터 제공이 시작됩니다.

빠르고 확실한 TAT
빠르고 확실한 TAT

QC 통과 후 약 2주 후 데이터 제공이 시작됩니다.

데이터 퀄리티 보장
데이터 퀄리티 보장

저희 데이터는 제조사의 성능 표시 기준을 넘어서는 퀄리티가 나옵니다.

데이터 퀄리티 보장
데이터 퀄리티 보장

저희 데이터는 제조사의 성능 표시 기준을 넘어서는 퀄리티가 나옵니다.

연구 및 의학 분야에서의 mRNA-Seq 활용

다양한 연구 목표를 지원하도록 설계된 노보진의 mRNA-seq 서비스를 통해 강력한 가능성을 경험해 보세요!

Diversity 탐구

다양한 조직, 다른 조건, 처리군에 걸친 전사체 프로파일을 이해합니다.

Diversity 탐구

다양한 조직, 다른 조건, 처리군에 걸친 전사체 프로파일을 이해합니다.

새로운 인사이트 발견

Novel transcript 발견, Alternative splicing, 변이를 확인하여 포괄적인 분석을 제공합니다.

새로운 인사이트 발견

Novel transcript 발견, Alternative splicing, 변이를 확인하여 포괄적인 분석을 제공합니다.

발달 및 내성 연구

Time point에 따른 유전자 발현비교를 통해 발달 메커니즘과 약물 내성을 연구합니다.

발달 및 내성 연구

Time point에 따른 유전자 발현비교를 통해 발달 메커니즘과 약물 내성을 연구합니다.

바이오마커 스크리닝

새로운 Transcript, SNP/InDel 식별, Gene Fusion 발견을 활용해 잠재적인 바이오마커를 찾아보세요.

바이오마커 스크리닝

새로운 Transcript, SNP/InDel 식별, Gene Fusion 발견을 활용해 잠재적인 바이오마커를 찾아보세요.

통합 오믹스 연계 분석

전사체 데이터를 다른 오믹스와 결합하여 전체적인 관점을 제공합니다.

통합 오믹스 연계 분석

전사체 데이터를 다른 오믹스와 결합하여 전체적인 관점을 제공합니다.

임상 인사이트

정확한 임상 진단을 위해 병원성 기전과 임상 아형을 조사합니다.


임상 인사이트

정확한 임상 진단을 위해 병원성 기전과 임상 아형을 조사합니다.


세부사항

샘플 준비방법

샘플 양은 참고용으로만 제시되어 있습니다. 자세한 내용은 샘플준비 가이드를 다운로드하여 확인하세요. 자세한 정보가 필요하시면 맞춤 요청을 가지고 저희에게 연락해주세요.

ServiceSample TypeAmount (Qubit®)VolumeConcentrationRIN (Agilent 2100)Purity (NanoDrop™)
Eukaryotic mRNA
(PolyA enrichment)
Total RNA
(Animal/Plant/Fungus)
≥ 200 ng≥ 20 μL≥ 10 ng/μL≥ 4.0, with flat baselineOD260/280 ≥ 2.0;
OD260/230 ≥ 2.0;
no degradation, no contamination
Total RNA
(Blood)
≥ 400 ng≥ 20 μL≥ 20 ng/μL≥ 5.0, with flat baseline
Strand-specific Eukaryotic mRNA
(PolyA enrichment)
Total RNA
(Animal/Plant/Fungus)
≥ 400 ng≥ 20 μL≥ 20 ng/μL≥ 5.0, with flat baseline
Total RNA
(Blood)
≥ 400 ng≥ 20 μL≥ 20 ng/μL≥ 5.0, with flat baseline

시퀀싱 & 데이터 분석

권장 데이터 생산량과 표시되는 분석 내용은 참고용일 뿐입니다. 자세한 정보가 필요하시면 맞춤 요청을 가지고 저희에게 연락해주세요.

Sequencing PlatformIllumina NovaSeq System
Read LengthPaired-end 150 bp
Recommended Data Amount• ≥ 20 million read pairs per sample for species with reference genome
• ≥ 50 million read pairs per sample for species without reference genome (de novo transcriptome assembly projects)
Data Analysis CapabilitymRNA-seq analysis with reference genome
•Data quality control
•Gene expression quantification
•Differential expression profiling
•Functional enrichment analysis
•Novel gene prediction
•SNP & InDel analysis
•Alternative splicing (AS) analysis
•Fusion gene prediction
•Protein-Protein Interaction (PPI) analysis
•Oncogene functional annotation
mRNA-seq analysis without reference genome
•Data quality control
•De novo transcriptome assembly
•Gene functional annotation
•CDS prediction
•SSR analysis
•Gene expression quantification
•Differential expression profiling
•Functional enrichment analysis

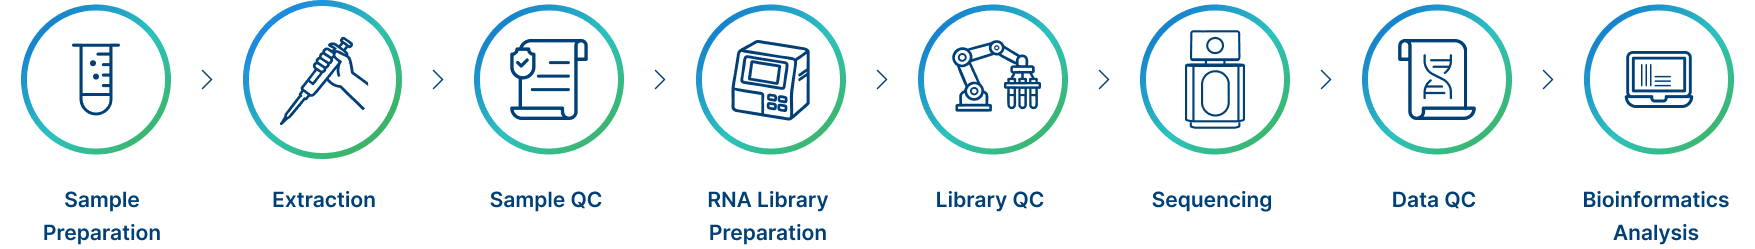
프로젝트 워크플로우

저희의 mRNA시퀀싱 워크플로우는 엄격하고 체계적인 과정을 통해 고품질 결과를 보장합니다:

프로젝트 워크플로우

데이터 분석 예시

Image
Image
1/1
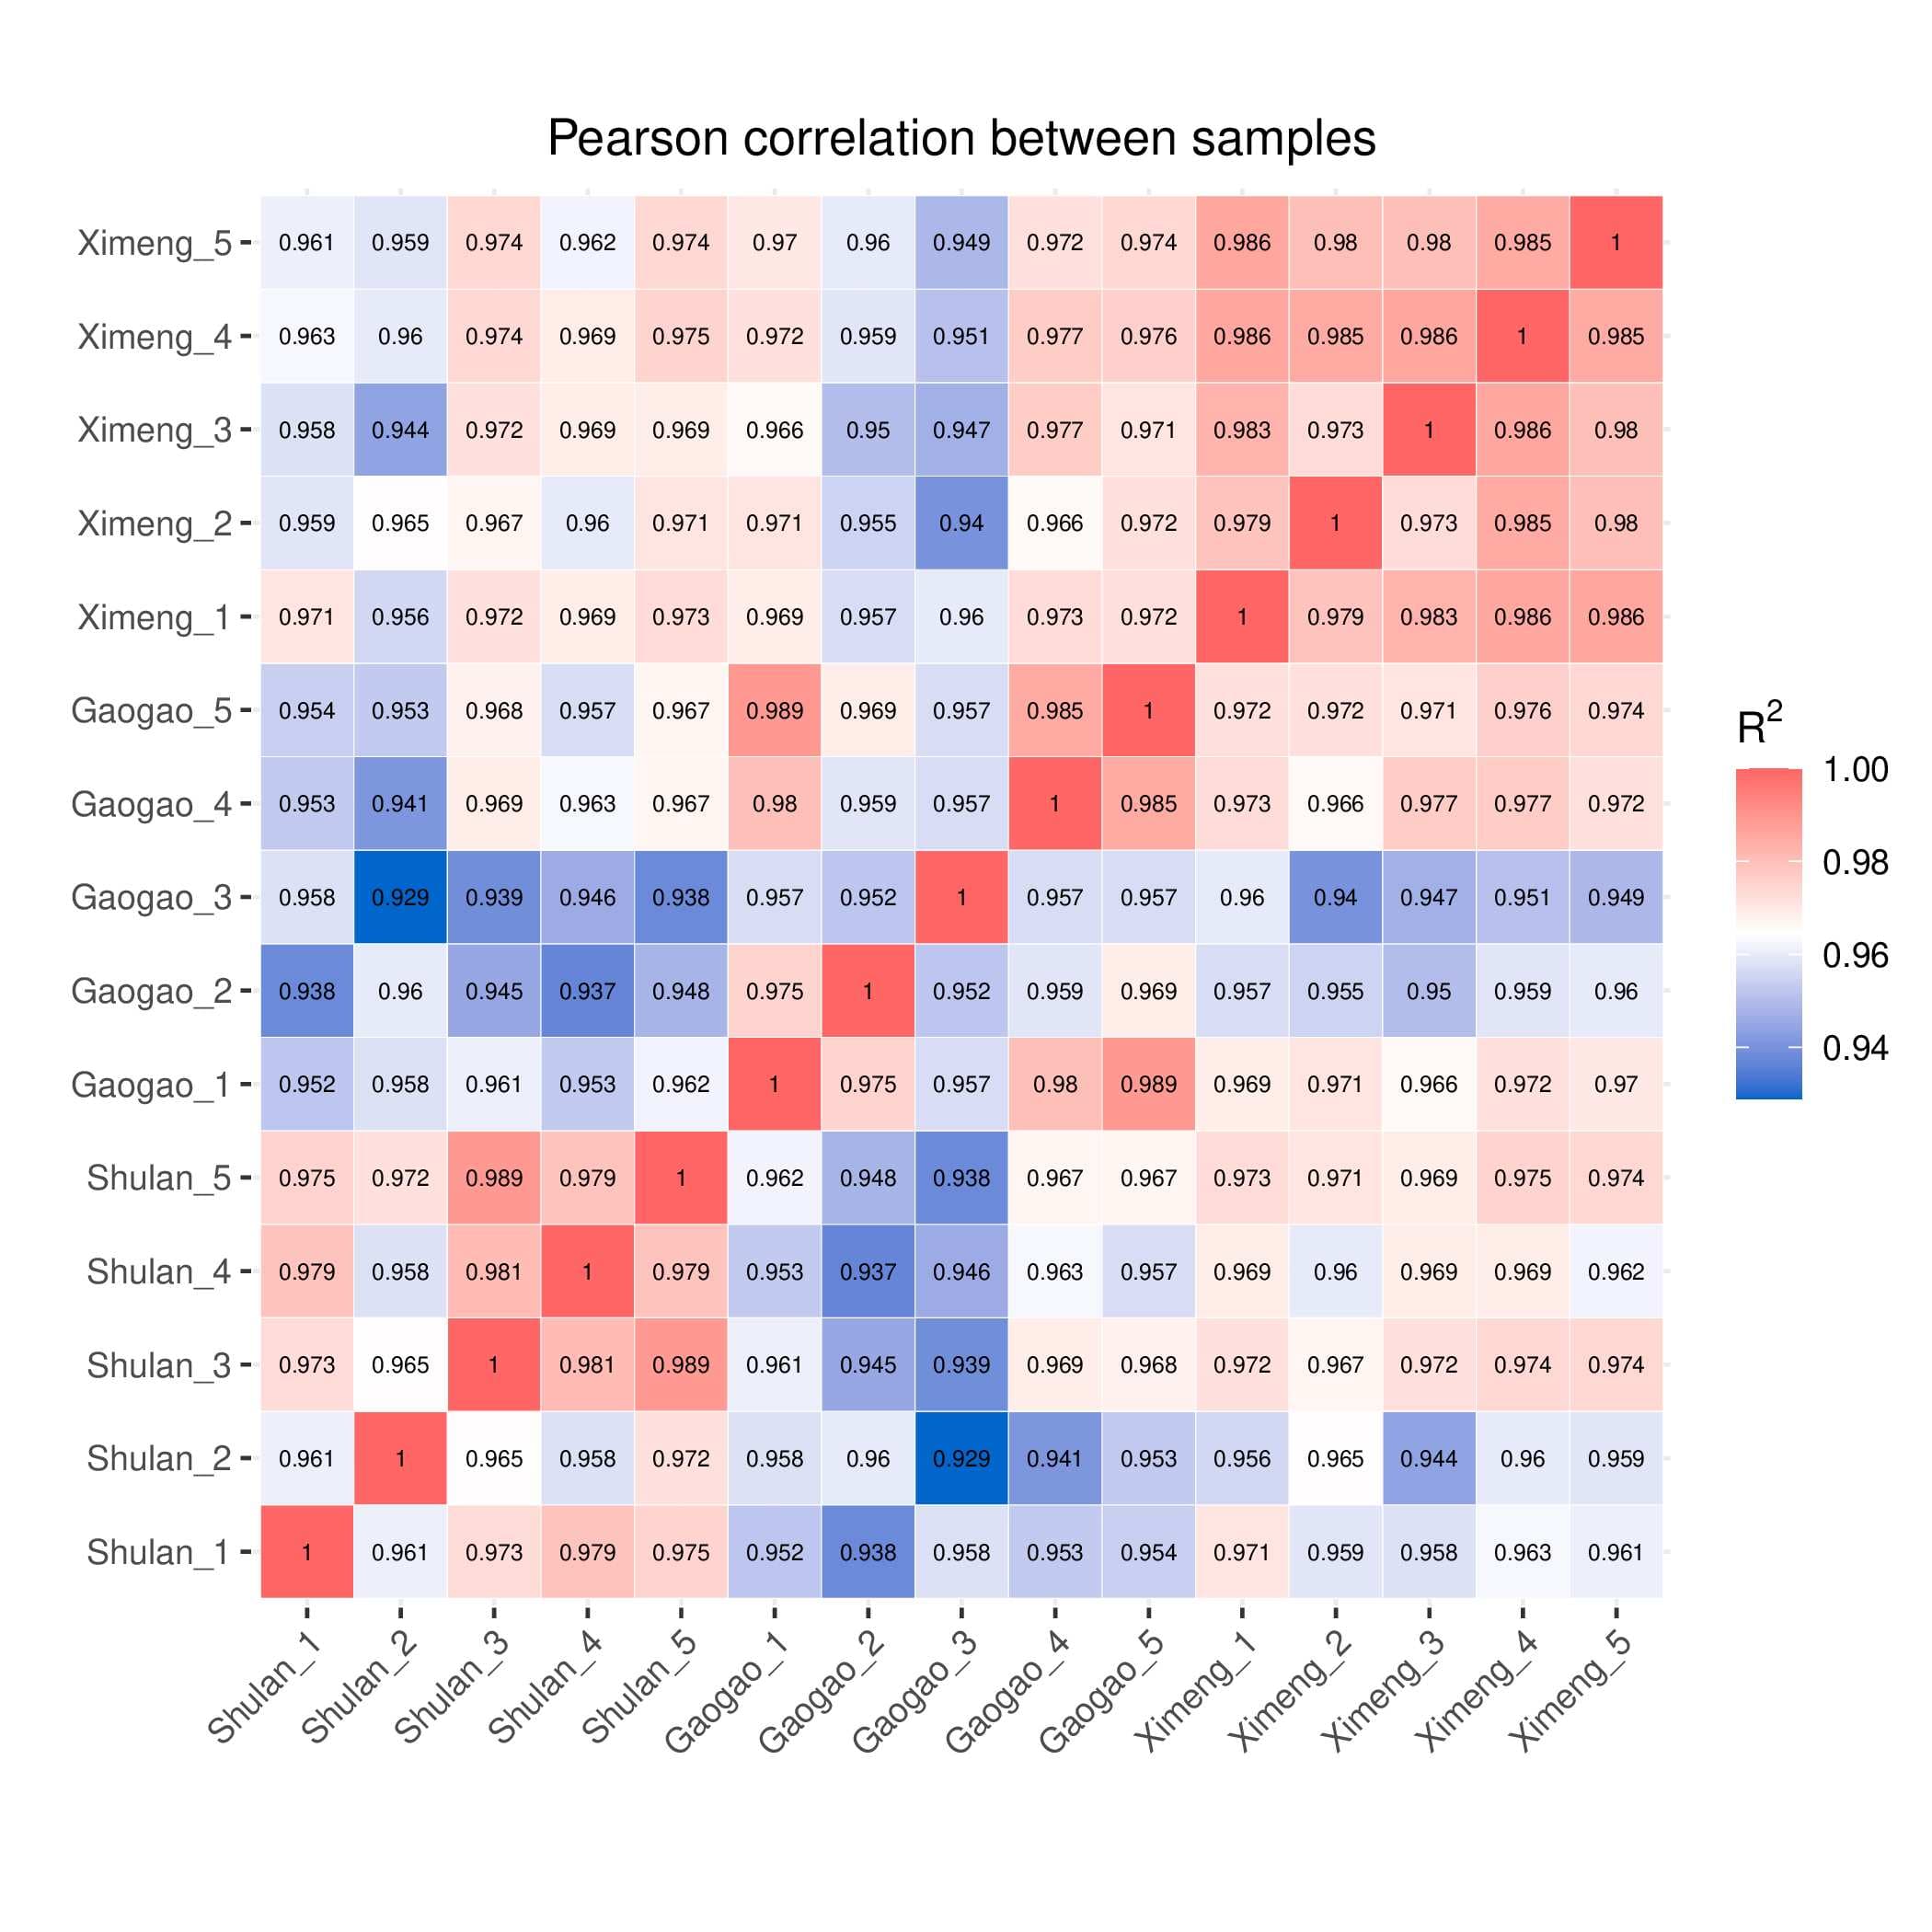
상관관계 분석

샘플 간 상관관계를 히트맵으로 시각화하는 분석이다.

Image
Image
1/1
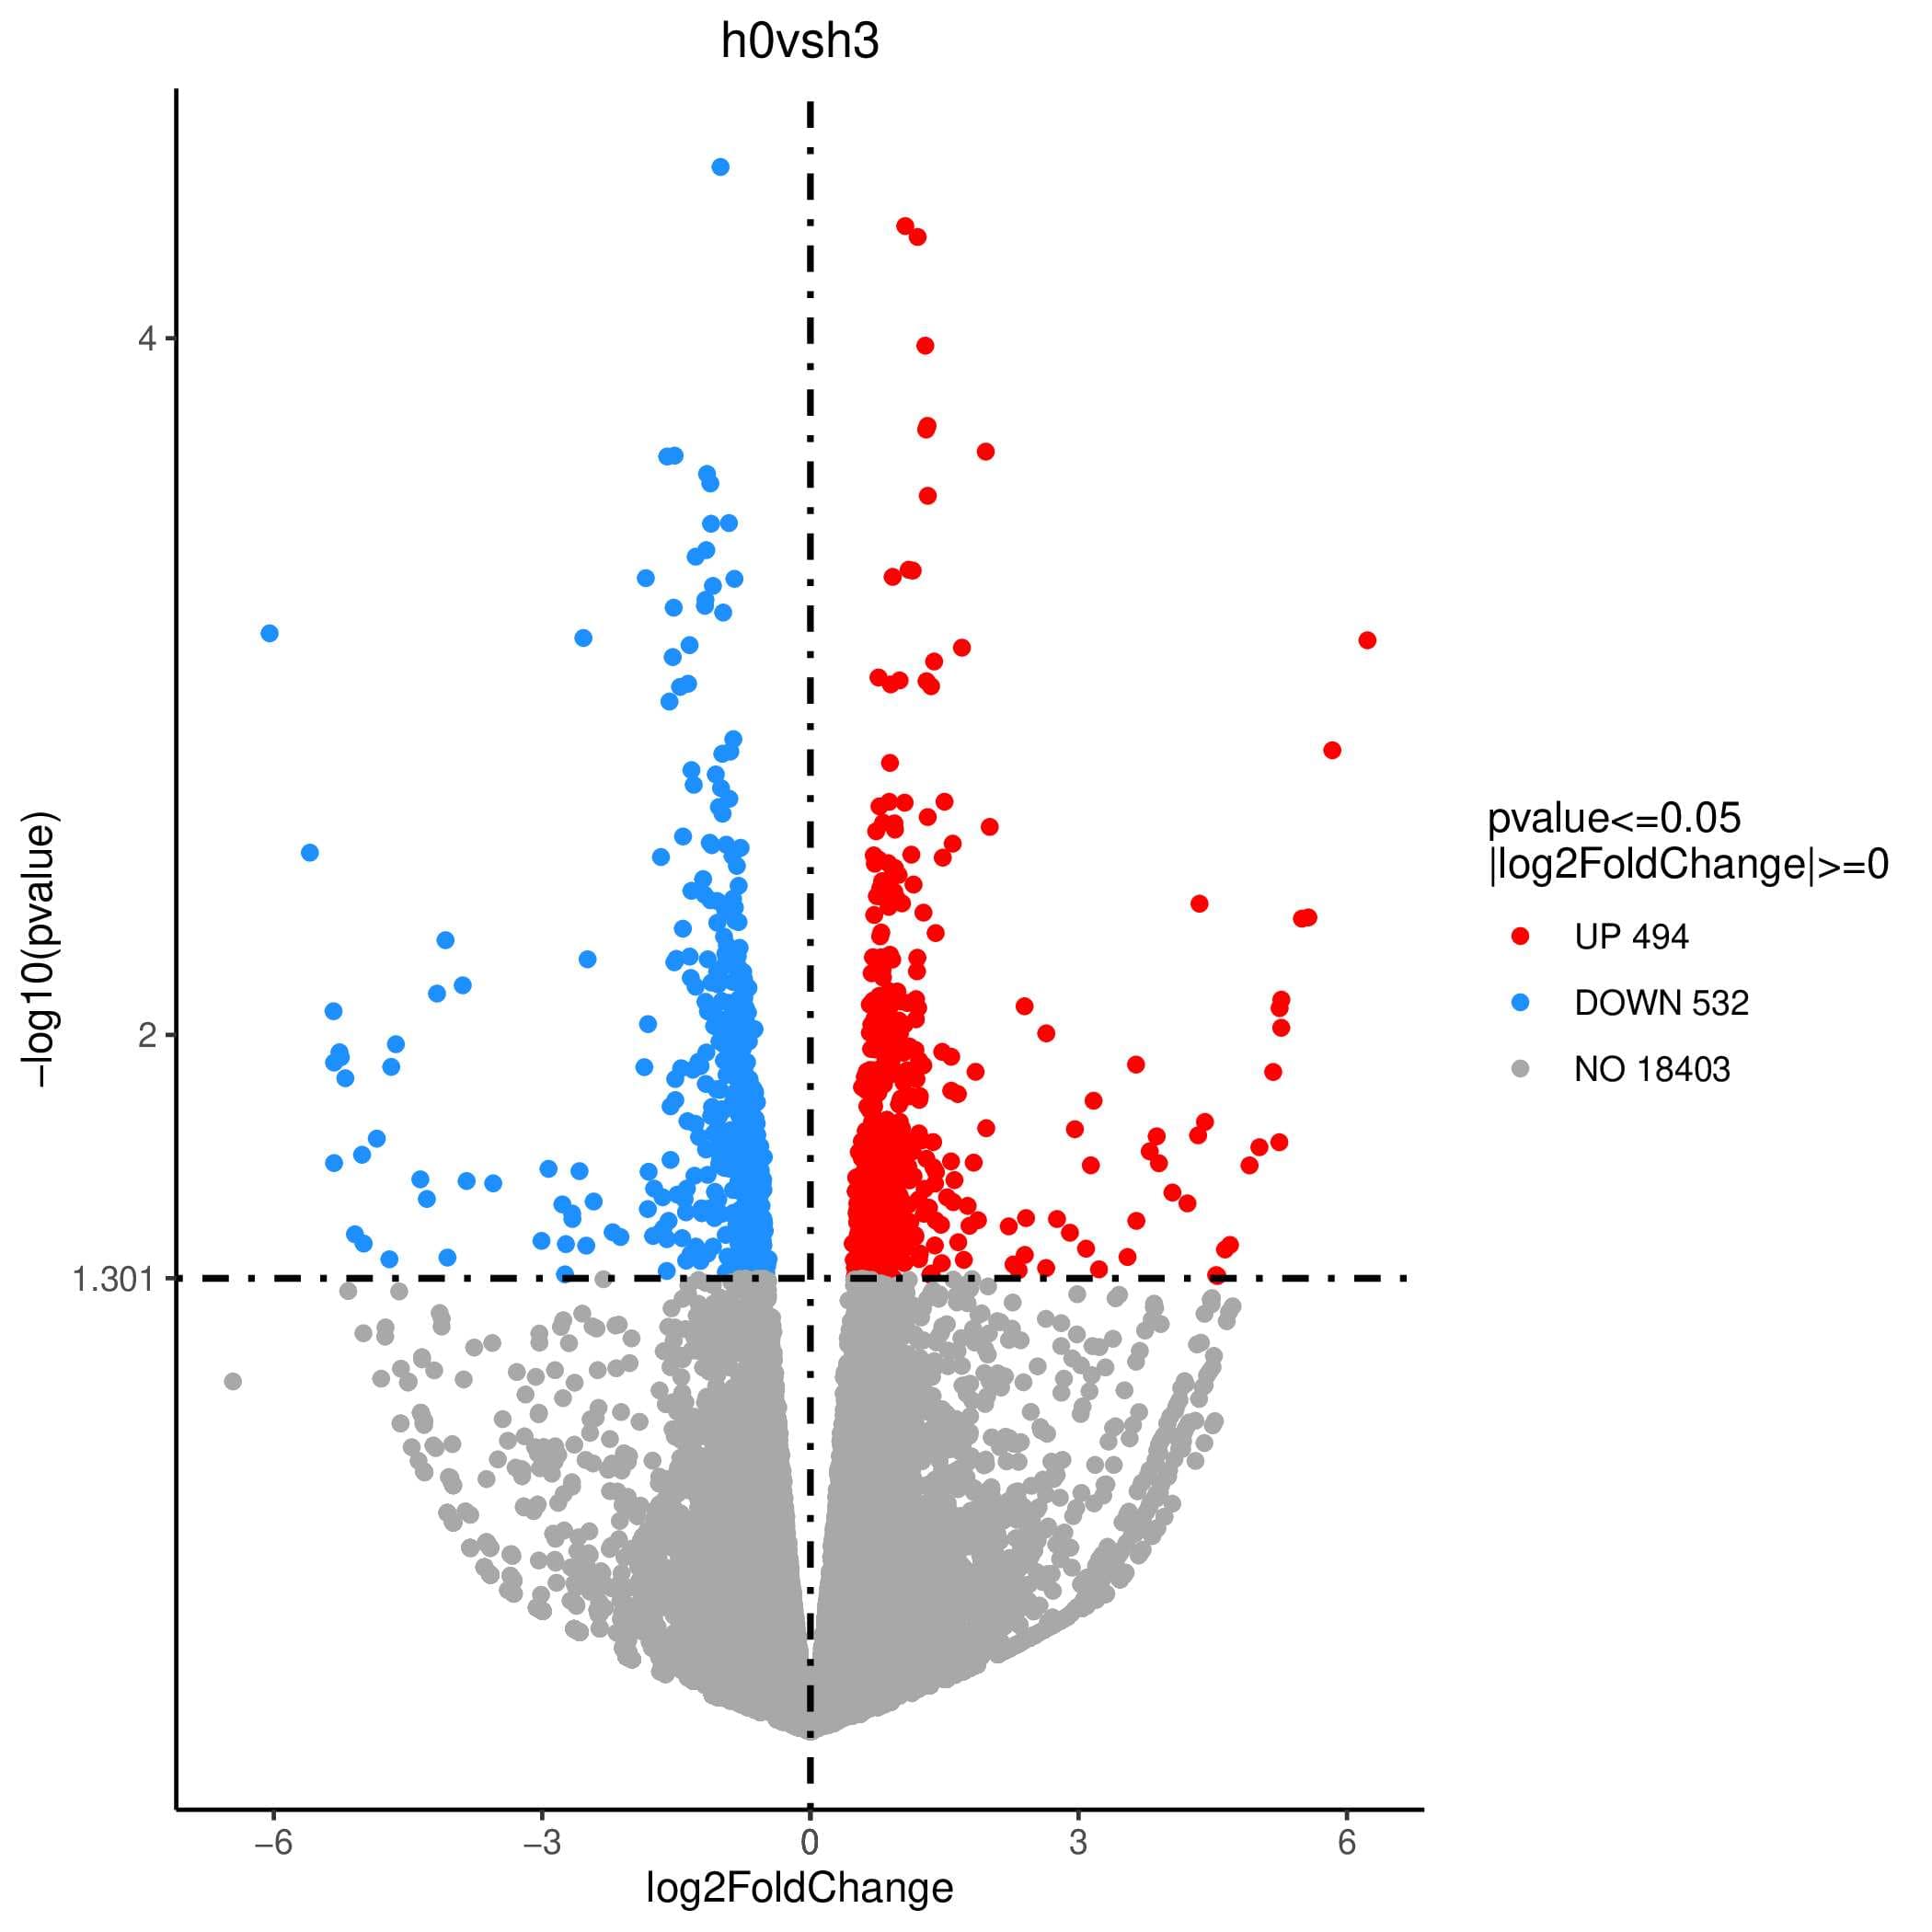
Volcano 차등발현 그래프 (DEG)

유의미하게 상향 및 하향 조절된 유전자들의 Volcano 플롯.

Image
Image
1/1
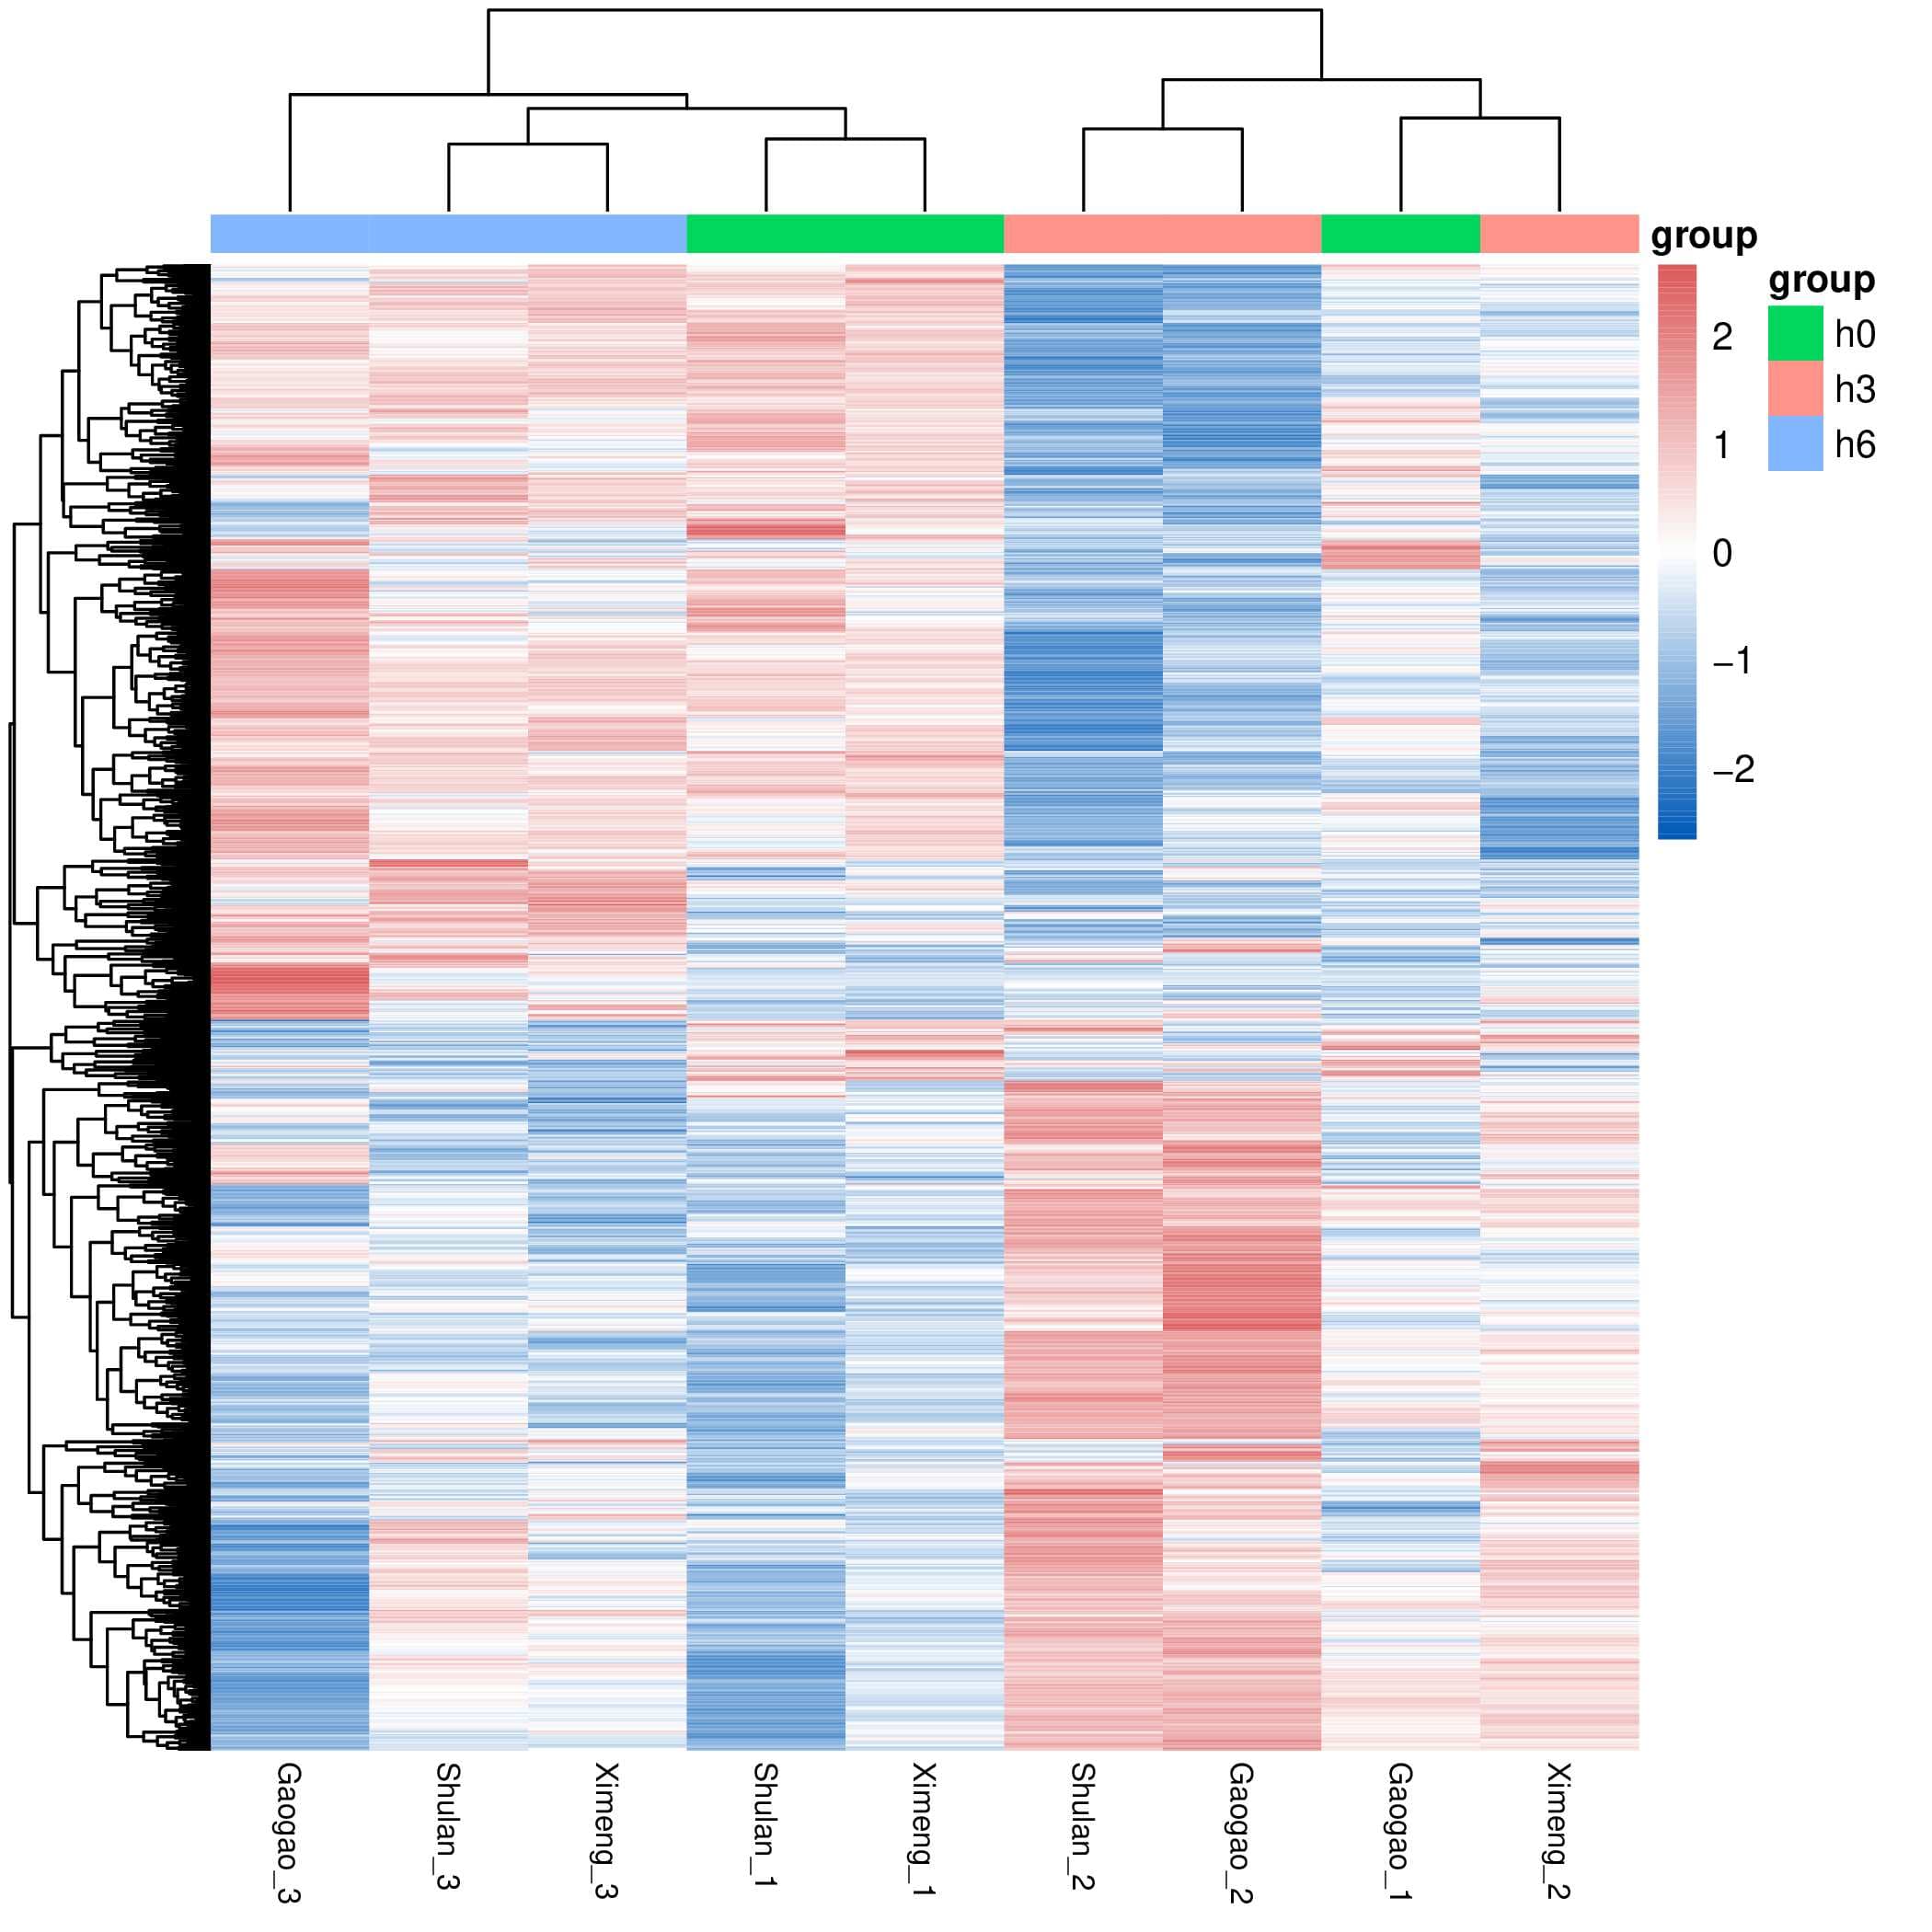
히트맵: 차등발현 유전자 분석 (DEG)

서로 다른 샘플 그룹에 걸친 DEGs의 클러스터링 발현 프로파일링.

Image
Image
1/1
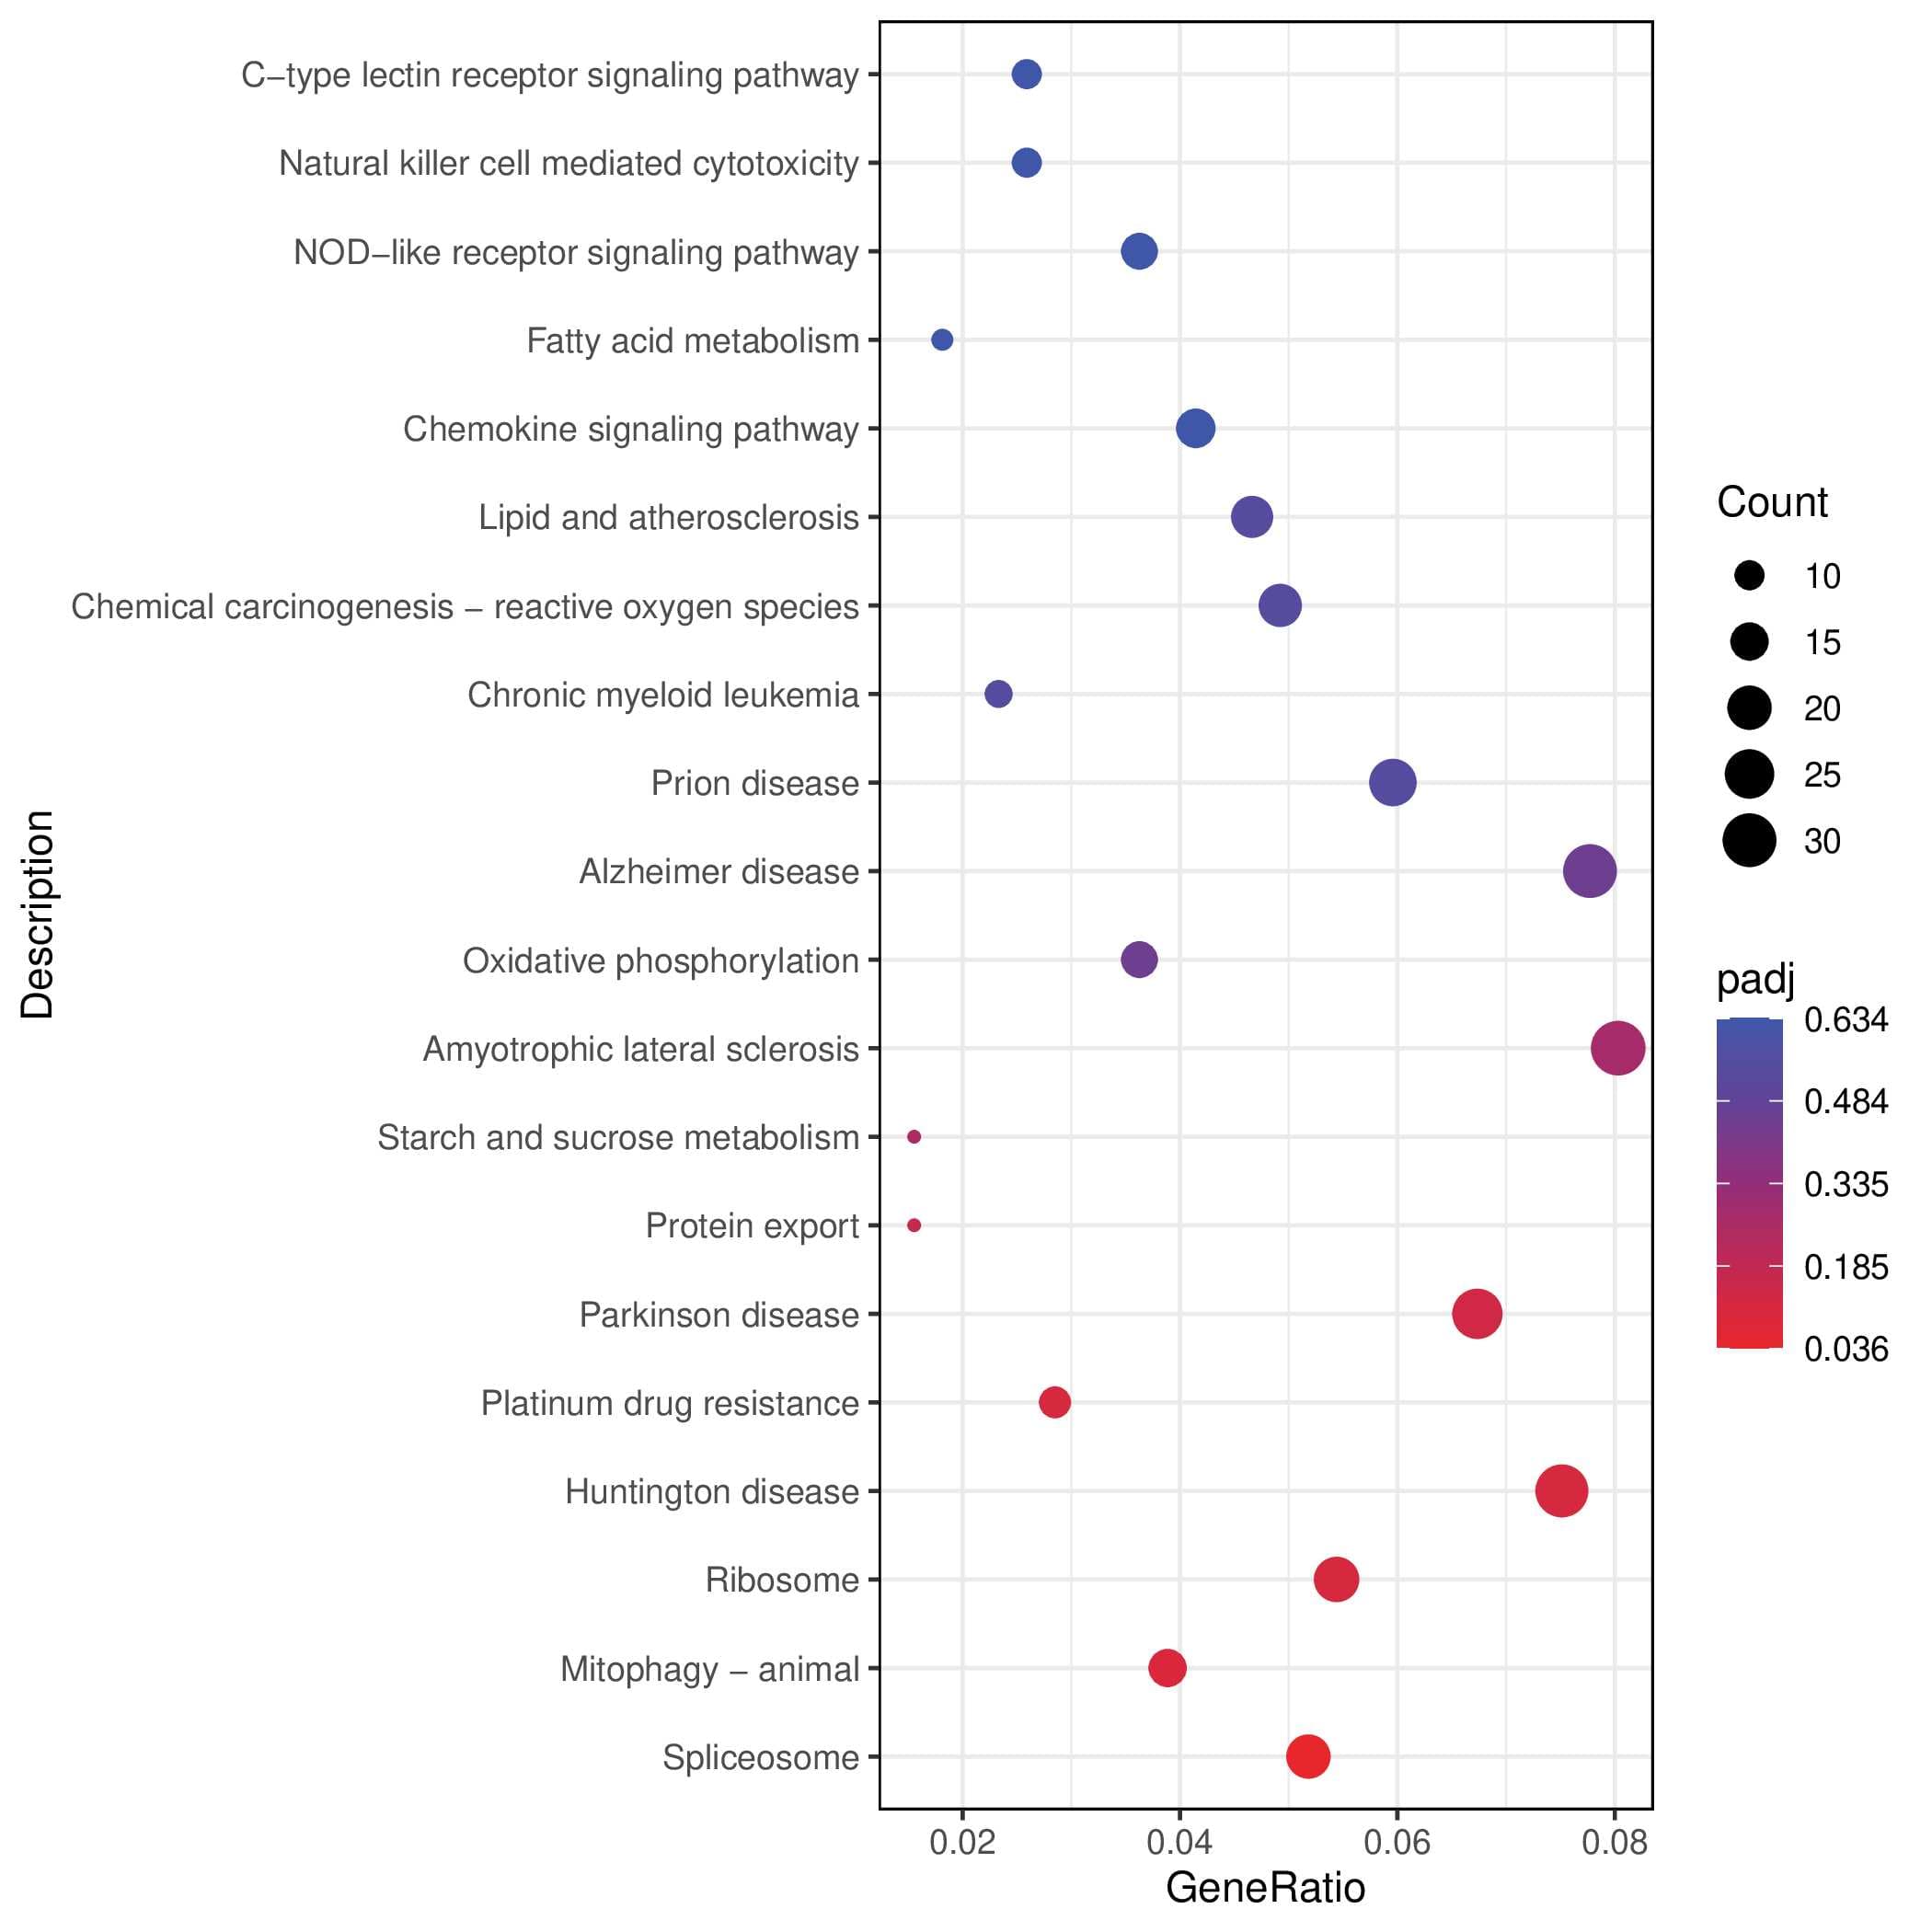
KEGG 분석

KEGG 데이터베이스를 기반으로 DEGs 간의 풍부한 생물학적 경로를 표현합니다.

Image
Image
1/1
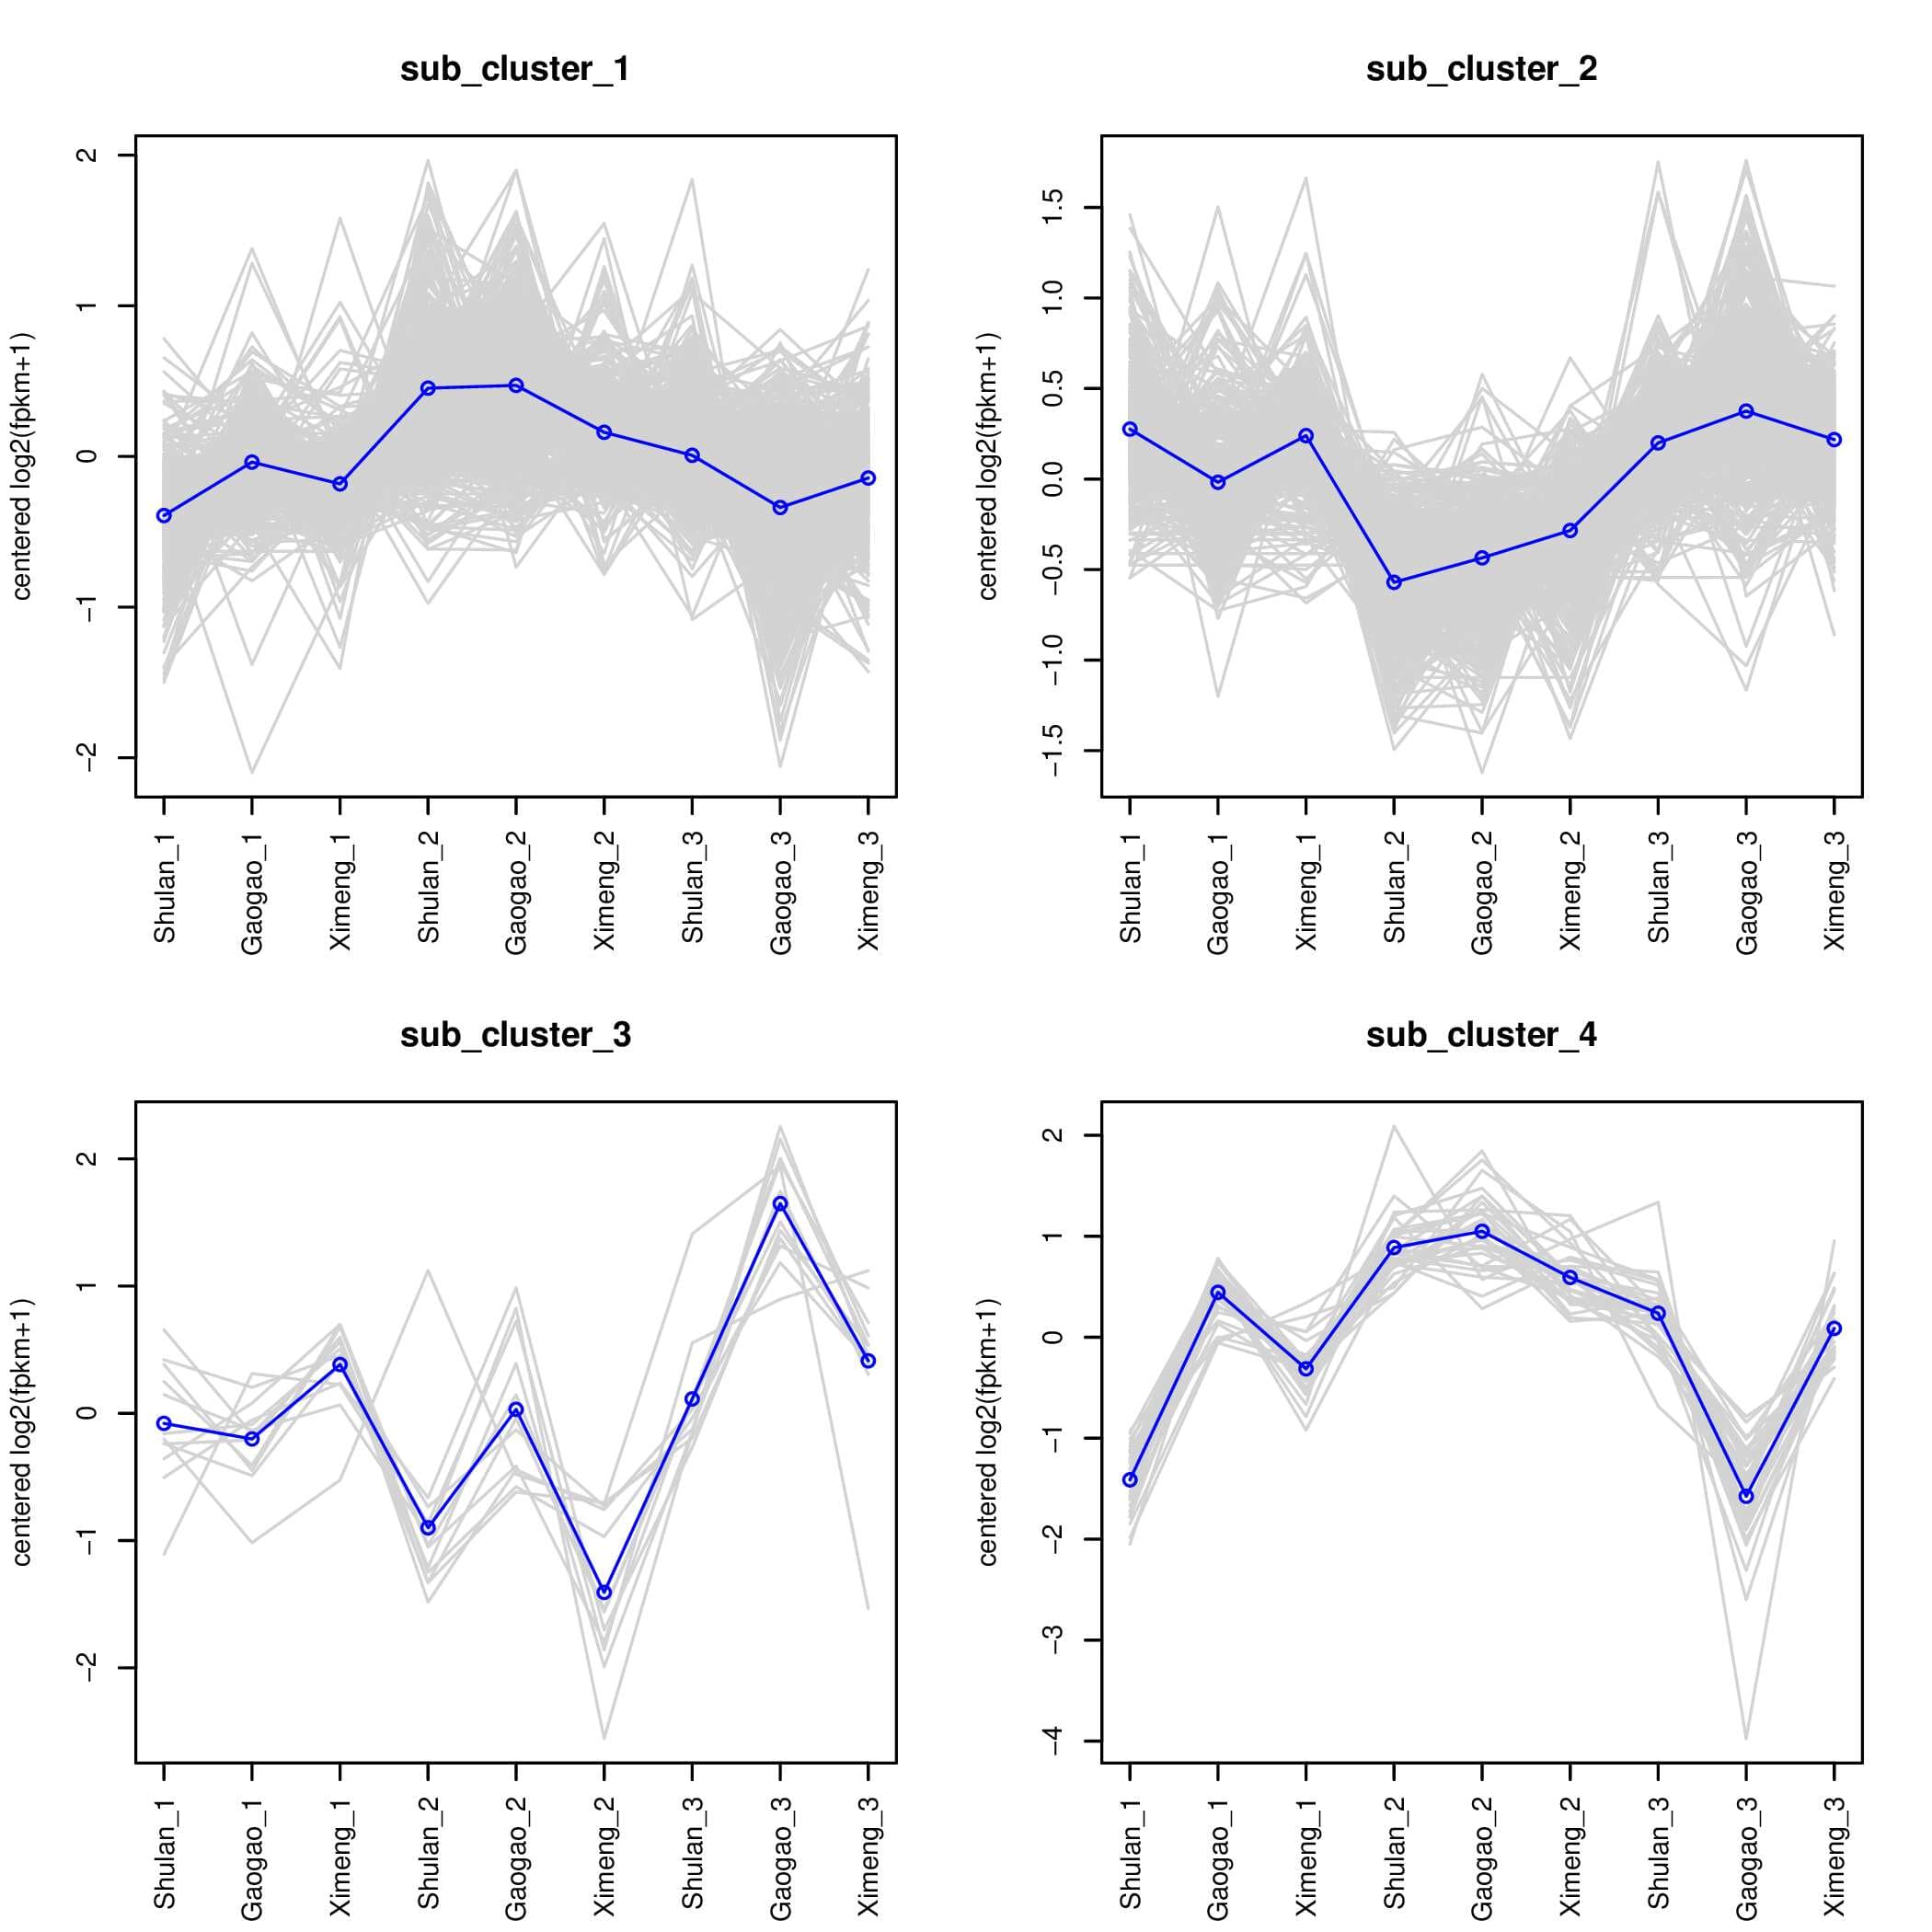
DEG 유전자의 계층 클러스터링

같은 클러스터 내의 유전자들은 처리 조건에 따라 조정된 발현 변화를 보입니다.

Image
Image
1/1
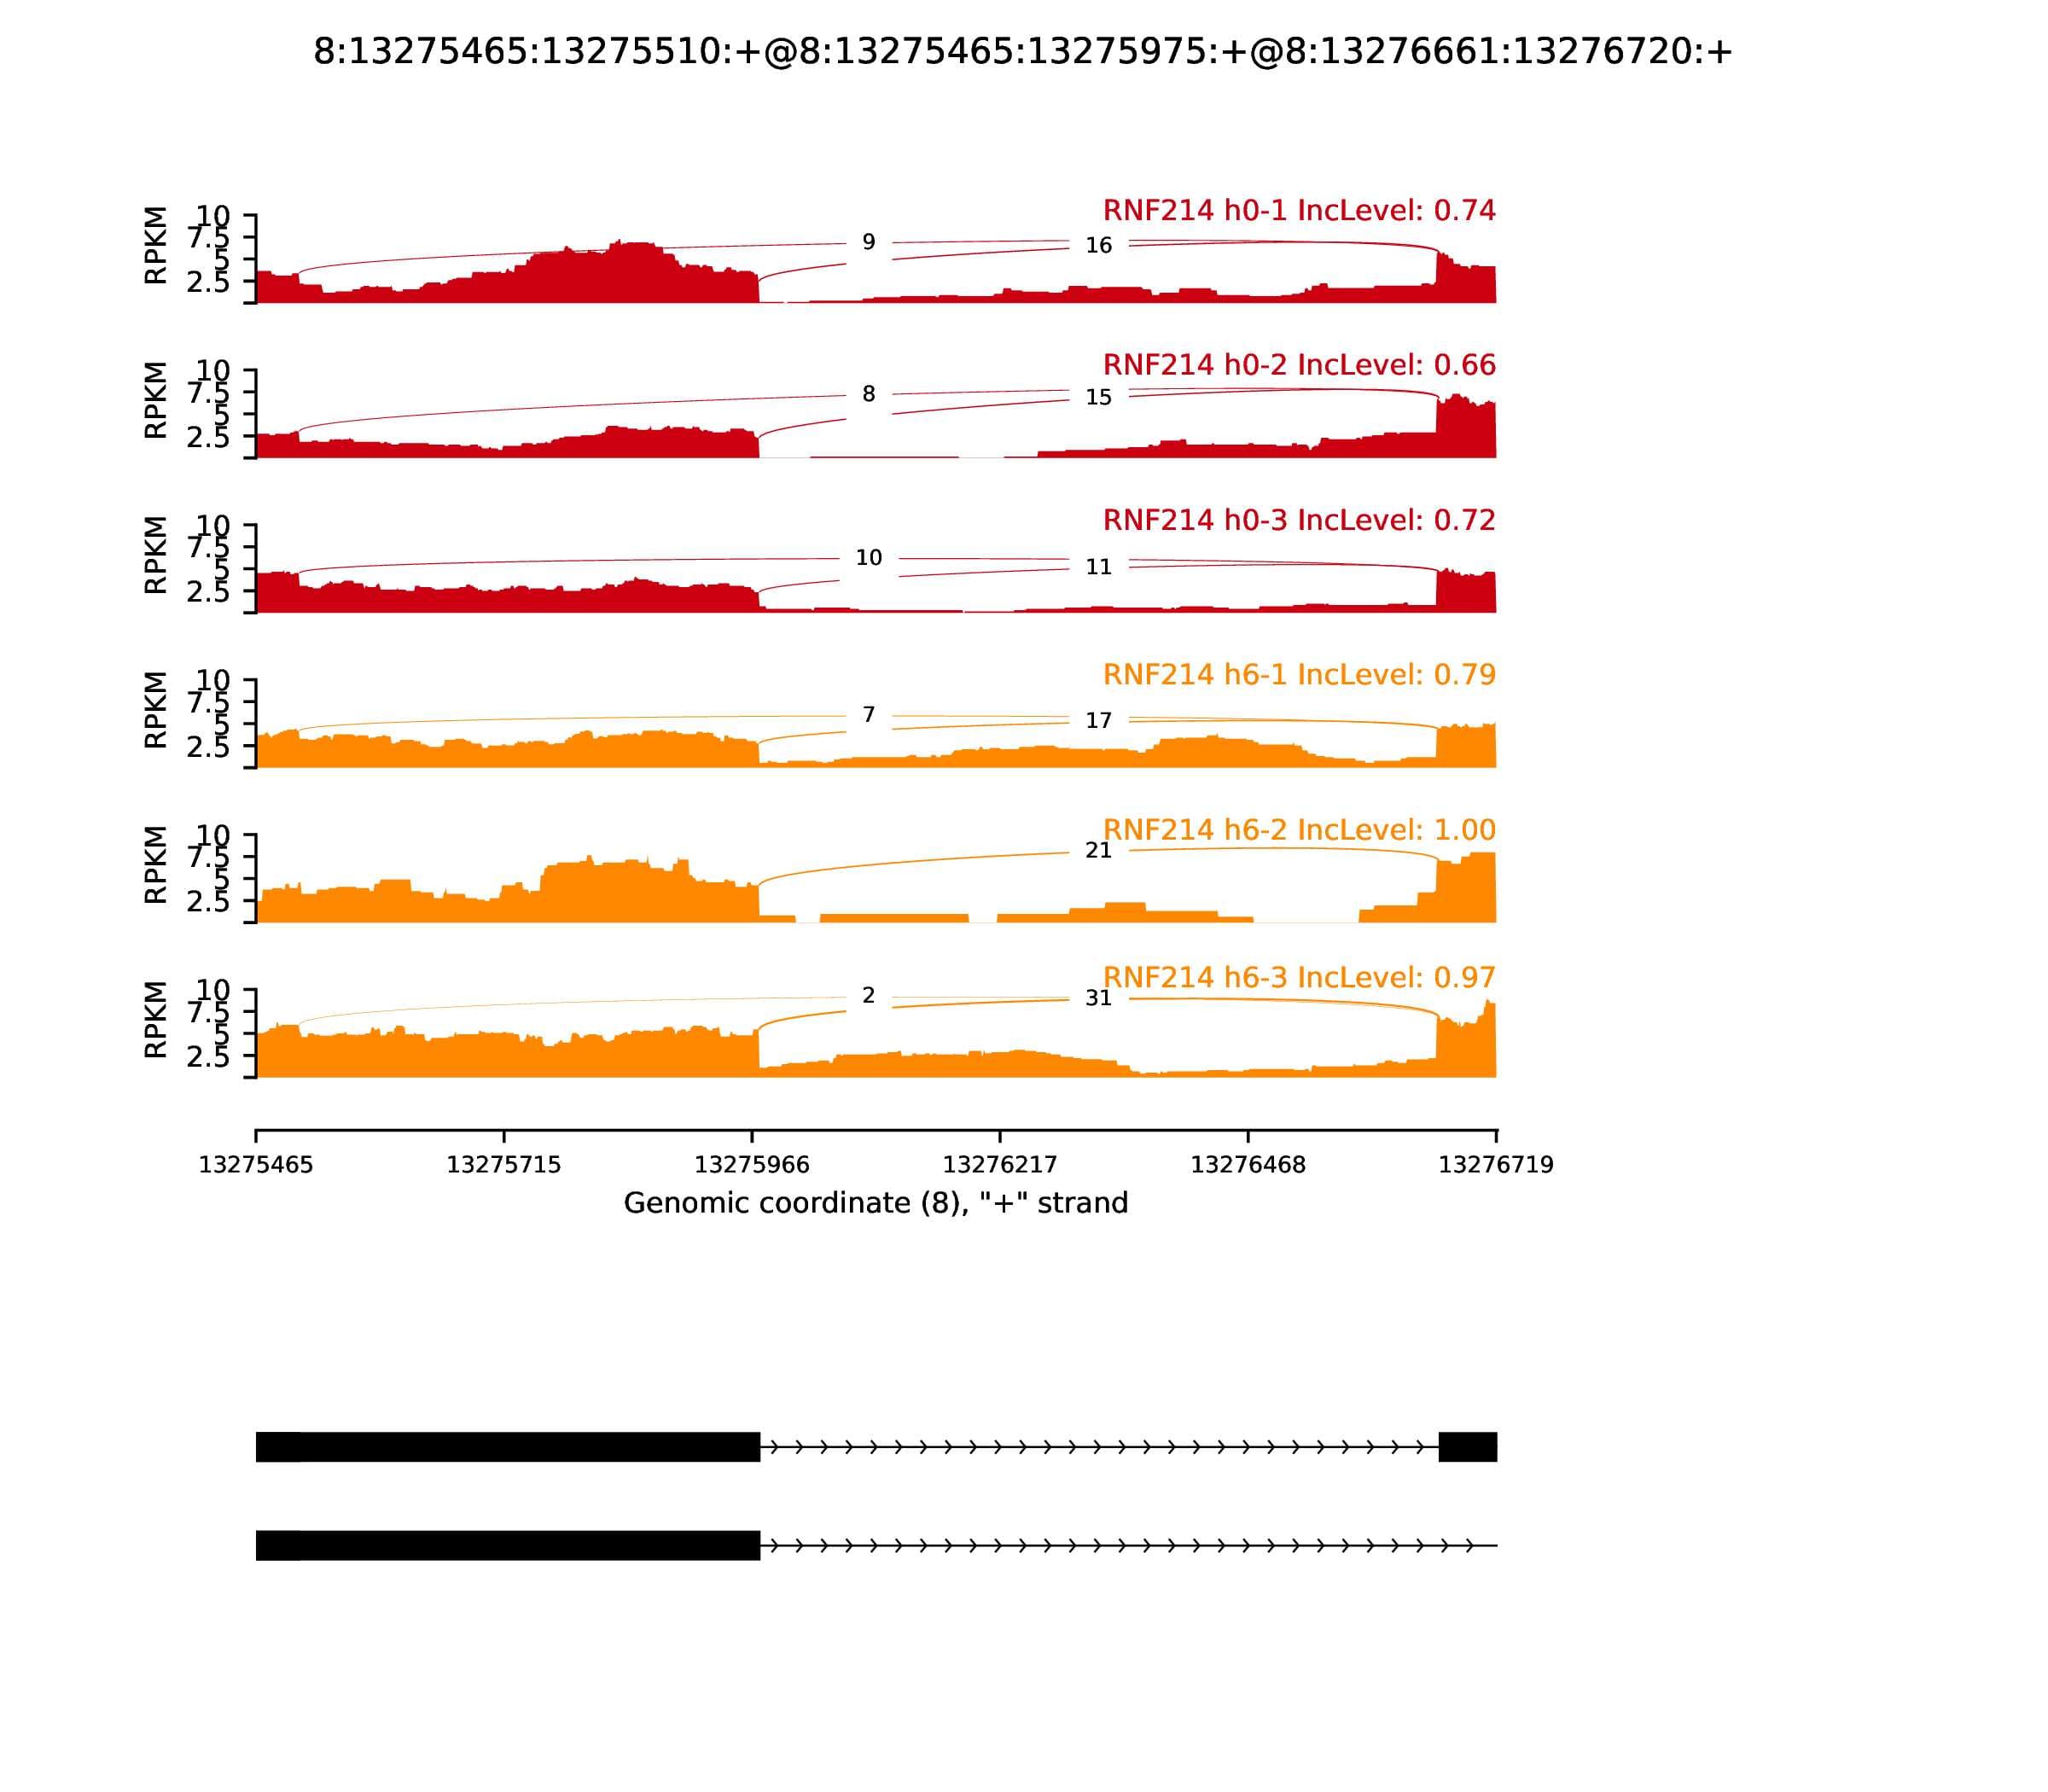
Alternative Splicing 그래프

rMATS 소프트웨어로 확인한 차등 대체 스플라이싱 이벤트들을 시각적으로 확인합니다.

Image
Image
1/1
상관관계 분석

샘플 간 상관관계를 히트맵으로 시각화하는 분석이다.

Image
Image
1/1
Volcano 차등발현 그래프 (DEG)

유의미하게 상향 및 하향 조절된 유전자들의 Volcano 플롯.

Image
Image
1/1
히트맵: 차등발현 유전자 분석 (DEG)

서로 다른 샘플 그룹에 걸친 DEGs의 클러스터링 발현 프로파일링.

Image
Image
1/1
KEGG 분석

KEGG 데이터베이스를 기반으로 DEGs 간의 풍부한 생물학적 경로를 표현합니다.

Image
Image
1/1
DEG 유전자의 계층 클러스터링

같은 클러스터 내의 유전자들은 처리 조건에 따라 조정된 발현 변화를 보입니다.

Image
Image
1/1
Alternative Splicing 그래프

rMATS 소프트웨어로 확인한 차등 대체 스플라이싱 이벤트들을 시각적으로 확인합니다.

FAQs (자주하시는 질문)

RNA-seq에 필요한 데이터생산량은 얼마가 좋을까요?

이상적인 데이터 양은 구체적인 연구 목표에 따라 다릅니다. 아래는 두 가지 일반적인 상황에 대한 기본 지침입니다:

•표준 차등 발현 분석의 경우, 샘플당 2천만 리드(≥3개의 생물학적 반복 포함)면 충분한 경우가 많습니다.

•저발현 유전자 검출(심층 프로파일링)의 경우, 샘플당 3천만에서 6천만 리드를 권장하며, 최소 3천만 리드부터 시작해 충분한 반복 수를 포함해야 합니다.

반복수는 얼마나 하는게 좋을까요?

Strand-specific RNA-seq은 어떨때 진행하면 좋나요?

RNA-seq 샘플을 준비하거나 보낼 때 주의사항이 있나요?

Bulk RNA-seq과 Single Cell RNA-seq의 차이점은 무엇인가요?

다른 서비스 탐색

Single Cell
(Single Cell)
Single Cell
(Single Cell)
Visium HD Spatial Gene Expression
(Visium HD Spatial Gene Expression)
Visium HD Spatial Gene Expression
(Visium HD Spatial Gene Expression)
Full-Length Transcriptome
(Full-Length Transcriptome)
Full-Length Transcriptome
(Full-Length Transcriptome)
Total RNA Seq
(Total RNA Seq)
Total RNA Seq
(Total RNA Seq)
Small RNA Seq
(Small RNA Seq)
Small RNA Seq
(Small RNA Seq)
Circular RNA Seq
(Circular RNA Seq)
Circular RNA Seq
(Circular RNA Seq)
Background
Background

프로젝트를 시작할 준비가 되셨나요?

문의 내용을 보내주시면 Novogene 전문가가 연락드리겠습니다.


Privacy PolicyCookie Policy